
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Fiyat
- ≈ $0,0012/çalıştırma
- Giriş → Çıkış
- Metin + Görüntü → Metin
- Geliştirici
- Community
- Güncellendi
- 23 Eylül 2026
Playground
Florence-2 Segmentation'ı deneyin
Giriş formu yok
Bu model için henüz giriş formu yok
Girdileri henüz belgelenmemiştir. Yanlış girdide hiçbir çalıştırmanın başarısız olmaması için burada form sunmuyoruz. Bunun yerine karşılaştırılabilir bir model seçin.
Examples
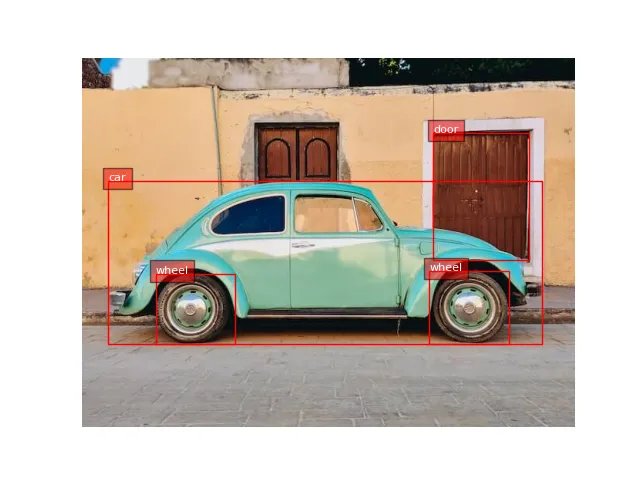 Open full size
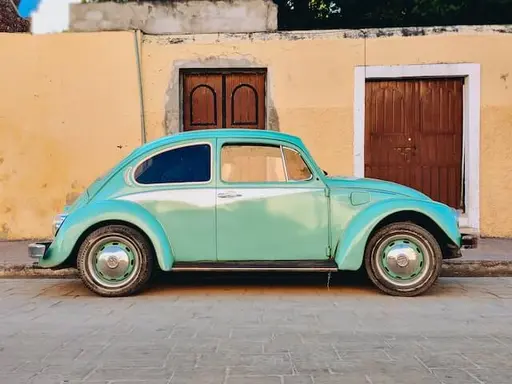 Input
No text prompt: the model only takes the input shown.
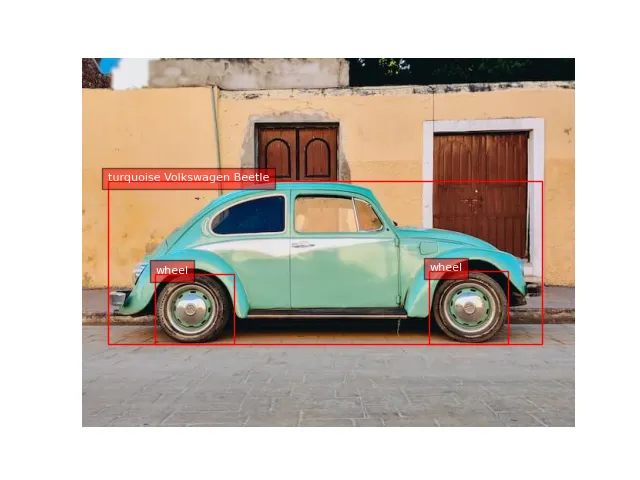 Open full size
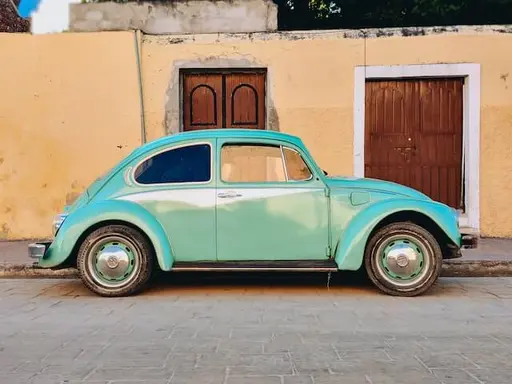 Input
No text prompt: the model only takes the input shown.
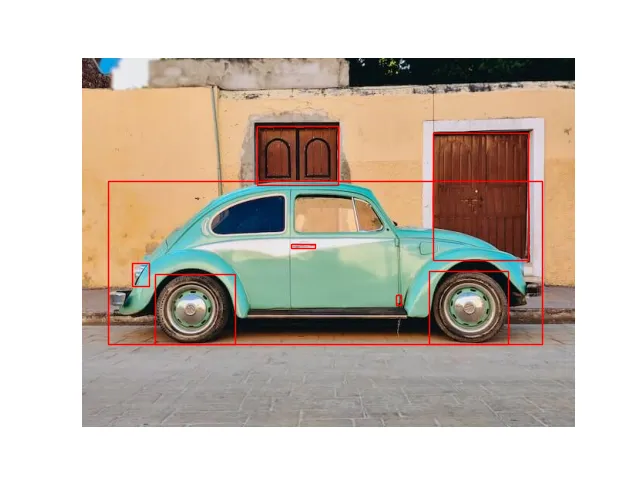 Open full size
 Input
No text prompt: the model only takes the input shown.
Florence-2 Segmentation Hakkında
Florence-2 Segmentation, Community tarafından Multimodal kategorisinde geliştirilen bir modeldir. Railwail üzerinde Florence-2 Segmentation maliyeti ≈ $0,0012 çalıştırma başına.
Fiyatlandırma
| Tipik çalıştırma (≈ 1 s, L40S üzerinde) | $0,0012 çalıştırma başına |
|---|---|
| GPU Süresi (L40S) | $0,00117 GPU saniyesi başına |
- Çalıştırmanın gerçekten aldığı GPU süresi için faturalandırılır. Çalıştırma başladığında, bakiyenizden tipik fiyatın 3 katı ayrılır ve daha sonra kapatılır.
- 1 kredi = $0,01
Maliyet Hesaplayıcı
Fiyat hesaplayıcı
Sağlayıcıya göre tipik: yaklaşık 1 s
Toplam
$0,12
12 kredi
Çalışma başına
$0,0012 · 0,12 kredi
Gerçek GPU süresi faturalandırılır; bu bir tahmindir.
API
Doğrulanmış API örneği yok
Genel API, bu modelin ihtiyaç duyduğundan farklı bir giriş biçimi iletir. Yukarıdaki oyun alanını kullanın.
Özellikler
- Model Kimliği
florence-2-segmentation- Geliştirici
- Community
- Kategori
- Multimodal
- Giriş
- Metin, Görüntü
- Çıkış
- Metin
- Faturalandırma
- Kullanıma göre (token veya GPU süresi)
- Katalog girişi güncellendi
- 23 Eylül 2026
Etiketler
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Sık Sorulan Sorular
Florence-2 Segmentation nedir?
Florence-2 Segmentation, Community tarafından Multimodal kategorisinde oluşturulan bir modeldir.
Florence-2 Segmentation Railwail'de ne kadar maliyetlidir?
Railwail üzerinde Florence-2 Segmentation maliyeti ≈ $0,0012 çalıştırma başına. Her istek gerçekten ne kadar kullanırsa o kadar ücretlendirilirsiniz. Kullanım ön ödemeli kredilerden ödenir; 1 kredi $0,01 değerindedir.
Florence-2 Segmentation ne kadar hızlıdır?
Railwail'de Florence-2 Segmentation için henüz çalıştırma süresi belirtmek için yeterli ölçülen çalıştırma yoktur. Bu, giriş, ayarlar ve sağlayıcıdaki yüke bağlıdır.
Florence-2 Segmentation, BLIP'dan daha iyi midir?
Bu göreve bağlıdır. Florence-2 Segmentation (Community) ve BLIP (Salesforce) her ikisi de Multimodal kategorisinde modellerdir. Karşılaştırma sayfası fiyatlarını ve özelliklerini yan yana gösterir.
Florence-2 Segmentation ve BLIP'ı karşılaştırFlorence-2 Segmentation görüntüleri işleyebilir mi?
Evet. Florence-2 Segmentation metne ek olarak giriş olarak görüntüleri kabul eder.
Karşılaştırılabilir modeller
Bu kategorideki tümü- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ $0,0457/çalıştırma
Birim başına 3.708 % daha pahalı
Florence-2 Segmentation ve CLIP Interrogator karşılaştır - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ $0,0050/çalıştırma
Birim başına 317 % daha pahalı
Florence-2 Segmentation ve Depth Anything v2 karşılaştır
Tüm Modeller Tek Bir API Aracılığıyla
Railwail'deki her model için bir API anahtarı. Kullanım, ön ödemeli kredilerden tahsil edilir, 1 kredi = $0,01.