
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Ціна
- ≈ 0,0114 USD/запуск
- Контекст
- 8 192 токенів
- Макс. вихід
- 2 048 токенів
- Вхід → вихід
- Текст + Зображення → Текст
- Розробник
- Community
- Оновлено
- 23 вересня 2026 р.
Playground
Спробувати CogVLM2 19B
Немає форми введення
Для цієї моделі поки що немає форми введення
Її введення ще не задокументовано. Щоб жоден запуск не зійшов на нівець через неправильне введення, ми не пропонуємо тут форму. Замість цього виберіть порівняльну модель.
Examples
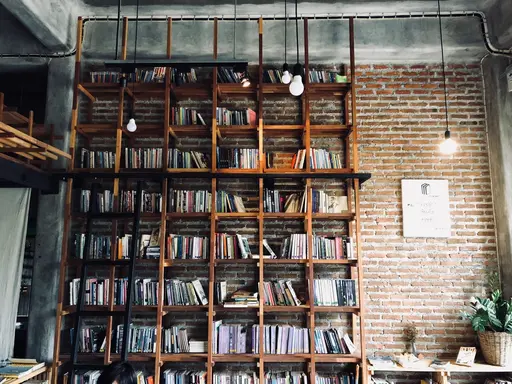 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
Про CogVLM2 19B
CogVLM2 19B — це модель від Community у категорії Мультимодальні. На Railwail CogVLM2 19B коштує ≈ 0,0114 USD за запуск. Контекстне вікно містить 8 192 токенів, а одна відповідь може бути довжиною до 2 048 токенів.
Ціни
| Типовий запуск (≈ 10 с на L40S) | 0,0114 USD за запуск |
|---|---|
| GPU-час (L40S) | 0,00117 USD за GPU-секунду |
- Оплачується за GPU-час, який насправді займає запуск. При запуску 3× типової ціни зарезервовується з вашого балансу та розраховується потім.
- 1 кредит = 0,01 USD
Калькулятор вартості
Калькулятор ціни
Типово за постачальником: близько 9,7 с
Всього
1,14 USD
114 кредитів
За запуск
0,0114 USD · 1,14 кредитів
Виставляється рахунок за фактичний час GPU; це оцінка.
API
Немає перевіреного прикладу API
Публічний API передає інший формат введення, ніж потребує ця модель. Використовуйте playground вище.
Характеристики
- ID моделі
cogvlm2-19b- Розробник
- Community
- Категорія
- Мультимодальні
- Вхідні дані
- Текст, Зображення
- Вихідні дані
- Текст
- Контекстне вікно
- 8 192 токенів
- Макс. вихідні дані
- 2 048 токенів
- Виставлення рахунків
- За використанням (токени або час GPU)
- Запис у каталозі оновлено
- 23 вересня 2026 р.
Теги
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Часті питання
Що таке CogVLM2 19B?
CogVLM2 19B — це модель від Community у категорії Мультимодальні.
Скільки коштує CogVLM2 19B на Railwail?
На Railwail CogVLM2 19B коштує ≈ 0,0114 USD за запуск. Вам буде виставлено рахунок за те, що насправді використовує кожен запит. Використання оплачується з попередньо придбаних кредитів; 1 кредит дорівнює 0,01 USD.
Яке контекстне вікно у CogVLM2 19B?
Контекстне вікно CogVLM2 19B містить 8 192 токенів. Одна відповідь може бути довжиною до 2 048 токенів.
Наскільки швидкий CogVLM2 19B?
На Railwail поки що недостатньо виміряних запусків CogVLM2 19B, щоб вказати час виконання. Це залежить від введення, налаштувань та навантаження у постачальника.
Чи CogVLM2 19B краще за BLIP?
Це залежить від завдання. CogVLM2 19B (Community) і BLIP (Salesforce) — обидві моделі в категорії Мультимодальні. На сторінці порівняння показані їхні ціни та специфікації поруч.
Порівняти CogVLM2 19B і BLIPЧи може CogVLM2 19B обробляти зображення?
Так. CogVLM2 19B приймає зображення як введення, крім тексту.
Порівнювані моделі
Усі в цій категорії- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Усі моделі через один API
Один API-ключ для всіх моделей на Railwail. Використання оплачується з попередньо поповнених кредитів, 1 кредит = 0,01 USD.