
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Ціна
- ≈ 0,0086 USD/запуск
- Контекст
- 4 096 токенів
- Макс. вихід
- 2 048 токенів
- Вхід → вихід
- Текст + Зображення → Текст
- Розробник
- DeepSeek
- Оновлено
- 23 вересня 2026 р.
Playground
Спробувати DeepSeek-VL 7B
Немає форми введення
Для цієї моделі поки що немає форми введення
Її введення ще не задокументовано. Щоб жоден запуск не зійшов на нівець через неправильне введення, ми не пропонуємо тут форму. Замість цього виберіть порівняльну модель.
Examples
 Input
Prompt
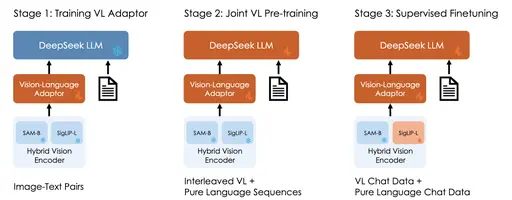
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Input
Prompt
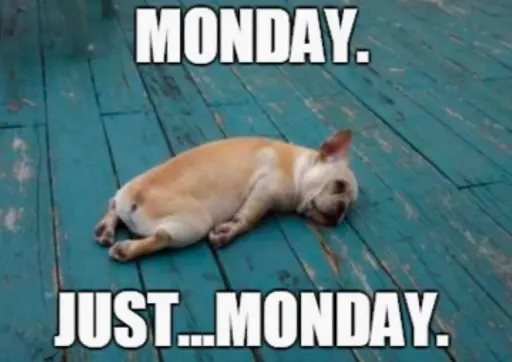
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Про DeepSeek-VL 7B
DeepSeek-VL 7B — це модель від DeepSeek у категорії Мультимодальні. На Railwail DeepSeek-VL 7B коштує ≈ 0,0086 USD за запуск. Контекстне вікно містить 4 096 токенів, а одна відповідь може бути довжиною до 2 048 токенів.
Ціни
| Типовий запуск (≈ 7 с на L40S) | 0,0086 USD за запуск |
|---|---|
| GPU-час (L40S) | 0,00117 USD за GPU-секунду |
- Оплачується за GPU-час, який насправді займає запуск. При запуску 3× типової ціни зарезервовується з вашого балансу та розраховується потім.
- 1 кредит = 0,01 USD
Калькулятор вартості
Калькулятор ціни
Типово за постачальником: близько 7,3 с
Всього
0,86 USD
86 кредитів
За запуск
0,0086 USD · 0,86 кредитів
Виставляється рахунок за фактичний час GPU; це оцінка.
API
Немає перевіреного прикладу API
Публічний API передає інший формат введення, ніж потребує ця модель. Використовуйте playground вище.
Характеристики
- ID моделі
deepseek-vl-7b- Розробник
- DeepSeek
- Категорія
- Мультимодальні
- Вхідні дані
- Текст, Зображення
- Вихідні дані
- Текст
- Контекстне вікно
- 4 096 токенів
- Макс. вихідні дані
- 2 048 токенів
- Виставлення рахунків
- За використанням (токени або час GPU)
- Запис у каталозі оновлено
- 23 вересня 2026 р.
Теги
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Часті питання
Що таке DeepSeek-VL 7B?
DeepSeek-VL 7B — це модель від DeepSeek у категорії Мультимодальні.
Скільки коштує DeepSeek-VL 7B на Railwail?
На Railwail DeepSeek-VL 7B коштує ≈ 0,0086 USD за запуск. Вам буде виставлено рахунок за те, що насправді використовує кожен запит. Використання оплачується з попередньо придбаних кредитів; 1 кредит дорівнює 0,01 USD.
Яке контекстне вікно у DeepSeek-VL 7B?
Контекстне вікно DeepSeek-VL 7B містить 4 096 токенів. Одна відповідь може бути довжиною до 2 048 токенів.
Наскільки швидкий DeepSeek-VL 7B?
На Railwail поки що недостатньо виміряних запусків DeepSeek-VL 7B, щоб вказати час виконання. Це залежить від введення, налаштувань та навантаження у постачальника.
Чи DeepSeek-VL 7B краще за BLIP?
Це залежить від завдання. DeepSeek-VL 7B (DeepSeek) і BLIP (Salesforce) — обидві моделі в категорії Мультимодальні. На сторінці порівняння показані їхні ціни та специфікації поруч.
Порівняти DeepSeek-VL 7B і BLIPЧи може DeepSeek-VL 7B обробляти зображення?
Так. DeepSeek-VL 7B приймає зображення як введення, крім тексту.
Порівнювані моделі
Усі в цій категорії- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Усі моделі через один API
Один API-ключ для всіх моделей на Railwail. Використання оплачується з попередньо поповнених кредитів, 1 кредит = 0,01 USD.