
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Ціна
- ≈ 0,0012 USD/запуск
- Вхід → вихід
- Текст + Зображення → Текст
- Розробник
- Community
- Оновлено
- 23 вересня 2026 р.
Playground
Спробувати Florence-2 Large
Введення та результат
Цей запуск
близько 0,0012 USD · 0,12 кредитів
На початку зарезервовано 0,0036 USD (0,36 кредитів); розраховується фактичний час GPU.
Новенький?
10 безплатних кредитів (0,10 USD) при реєстрації через Google
Доступно 24 годин після реєстрації, до 5 запусків на день і максимум 2 кредитів за запуск. Інші способи входу стартують без кредитів. Достатньо для 27 запусків цієї моделі.
Examples
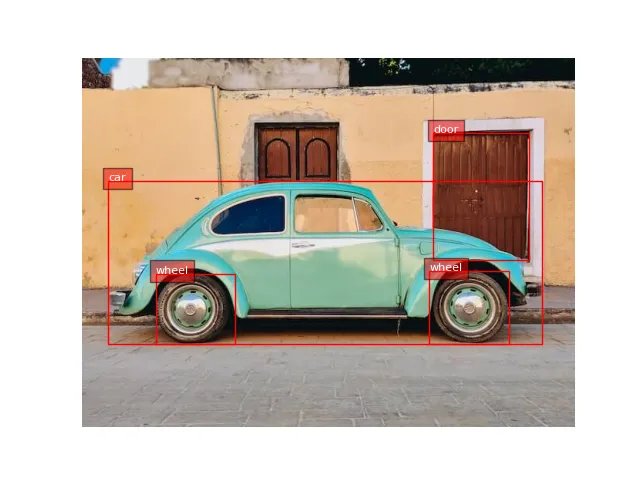 Open full size
 Input
No text prompt: the model only takes the input shown.
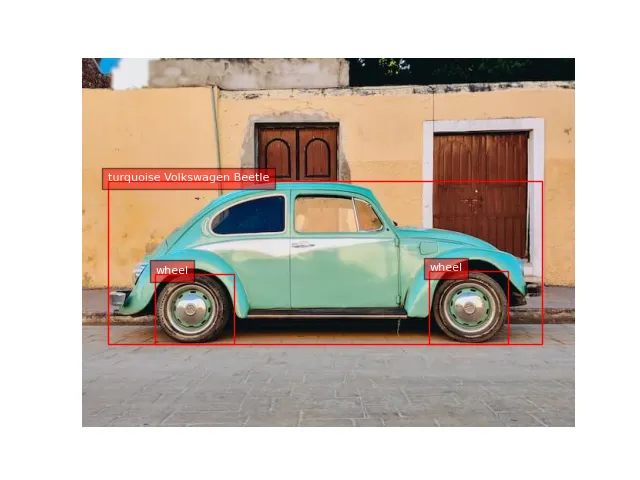 Open full size
 Input
No text prompt: the model only takes the input shown.
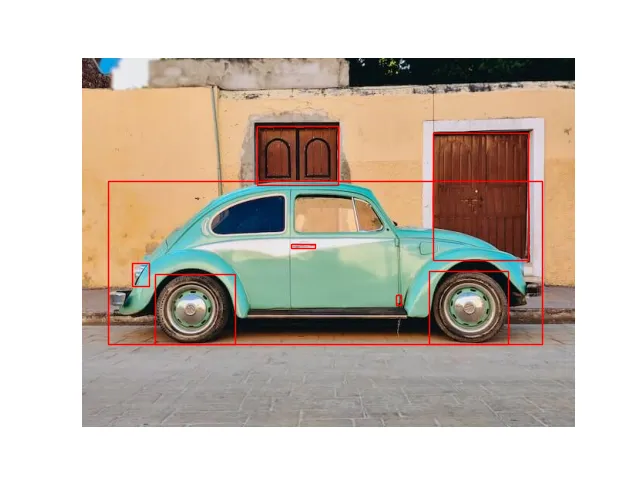 Open full size
 Input
No text prompt: the model only takes the input shown.
Про Florence-2 Large
Florence-2 Large — це модель від Community у категорії Мультимодальні. На Railwail Florence-2 Large коштує ≈ 0,0012 USD за запуск.
Ціни
| Типовий запуск (≈ 1 с на L40S) | 0,0012 USD за запуск |
|---|---|
| GPU-час (L40S) | 0,00117 USD за GPU-секунду |
- Оплачується за GPU-час, який насправді займає запуск. При запуску 3× типової ціни зарезервовується з вашого балансу та розраховується потім.
- 1 кредит = 0,01 USD
Калькулятор вартості
Калькулятор ціни
Типово за постачальником: близько 1 с
Всього
0,12 USD
12 кредитів
За запуск
0,0012 USD · 0,12 кредитів
Виставляється рахунок за фактичний час GPU; це оцінка.
API
Немає перевіреного прикладу API
Публічний API передає інший формат введення, ніж потребує ця модель. Використовуйте playground вище.
Характеристики
- ID моделі
florence-2-large- Розробник
- Community
- Категорія
- Мультимодальні
- Вхідні дані
- Текст, Зображення
- Вихідні дані
- Текст
- Виставлення рахунків
- За використанням (токени або час GPU)
- Запис у каталозі оновлено
- 23 вересня 2026 р.
Вхідні параметри
Вхідні дані та налаштування зі схеми вхідних даних моделі. Приклад у розділі API показує, які з них приймає API.
promptобов'язковоUser message or task instruction
Тип: ТекстЗа замовчуванням: –Допустимі значення: до 4 000 символівtaskТип: ВибірЗа замовчуванням:captionДопустимі значення: caption, detailed_caption, ocr, object_detection або segmentationimage_urlImage URL to analyze
Тип: ТекстЗа замовчуванням: –Допустимі значення: –max_tokensТип: Ціле числоЗа замовчуванням:1024Допустимі значення: 1 до 4 096temperatureТип: ЧислоЗа замовчуванням:0.7Допустимі значення: 0 до 2
Теги
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Часті питання
Що таке Florence-2 Large?
Florence-2 Large — це модель від Community у категорії Мультимодальні.
Скільки коштує Florence-2 Large на Railwail?
На Railwail Florence-2 Large коштує ≈ 0,0012 USD за запуск. Вам буде виставлено рахунок за те, що насправді використовує кожен запит. Використання оплачується з попередньо придбаних кредитів; 1 кредит дорівнює 0,01 USD.
Які налаштування підтримує Florence-2 Large?
Згідно зі схемою введення, Florence-2 Large знає такі параметри: prompt (до 4 000 символів), task (caption, detailed_caption, ocr, object_detection або segmentation), image_url, max_tokens (1 до 4 096) і temperature (0 до 2).
Наскільки швидкий Florence-2 Large?
На Railwail поки що недостатньо виміряних запусків Florence-2 Large, щоб вказати час виконання. Це залежить від введення, налаштувань та навантаження у постачальника.
Чи Florence-2 Large краще за BLIP?
Це залежить від завдання. Florence-2 Large (Community) і BLIP (Salesforce) — обидві моделі в категорії Мультимодальні. На сторінці порівняння показані їхні ціни та специфікації поруч.
Порівняти Florence-2 Large і BLIPЧи може Florence-2 Large обробляти зображення?
Так. Florence-2 Large приймає зображення як введення, крім тексту.
Порівнювані моделі
Усі в цій категорії- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Усі моделі через один API
Один API-ключ для всіх моделей на Railwail. Використання оплачується з попередньо поповнених кредитів, 1 кредит = 0,01 USD.