
Segformer B5
segformer-b5NVIDIA SegFormer-B5 semantic segmentation. Hierarchical transformer encoder with lightweight MLP decoder, strong ADE20k and Cityscapes results.
- Prezzo
- ≈ 0,00030 USD/esecuzione
- Input → output
- Testo + Immagine → Testo
- Sviluppatore
- Community
- Aggiornato
- 23 settembre 2026
Playground
Prova Segformer B5
Nessuna maschera di input
Nessun modulo di input per questo modello
I suoi input non sono ancora documentati. Per evitare errori di esecuzione, non offriamo un modulo qui. Scegli invece un modello comparabile.
Examples
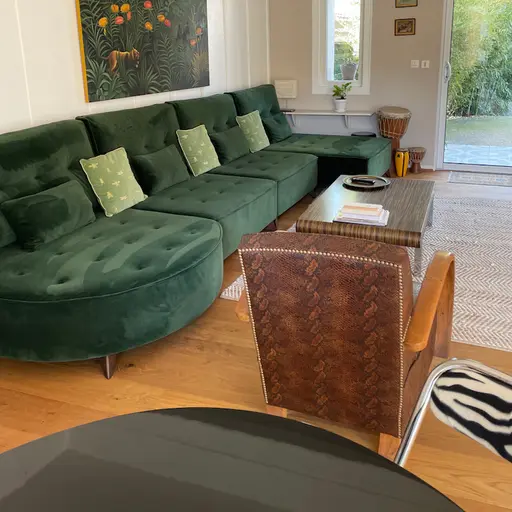 Input
No text prompt: the model only takes the input shown.
Output (JSON, shortened)
[
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAAJrklEQVR4nO3d2XbjthIFUDIr///LykNst9oiJQ4YCqi9H+5K36QtiTyHBcga1sfS2Nr6BhtofhDfq3iIPz7SI7dd5IcU8k+7m4J4FIDUFKCEGZd1SbQvQLD1MrmZAKSmAKSmAEXYBIxKAWgt1C7w3/Y3+XC5HNbd7IbK/rIsXQpANmdj3/IKaQlEUa9hf8S77D9RgDIiLev63pdfcY8df0sgint8NzB49P+nABQ3RPK/WAKRmgKQmgIQTdN…",
    "label": "wall",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAARoklEQVR4nO3d2XaruBYFUHzH+f9f5j4kqThuMI22tCXN+VB1uiQYrYUExvayAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAAA…",
    "label": "floor",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAAD/ElEQVR4nO3cUWrCQBRAUVO6/y3bj2IrtOJECMF3z1lAmOC7iegk24Vxrscdejvu0Of4OHsBcCYBkCYA0gRAmgBIEwBpAiBNAKQJgB3G/Q8mANoEQJoA5jlwK9A8AiBNAKQJgDQBkCYA0gRAmgBIEwBpAiBNAKQJgDQBkCYA0gRAmgBYN++BMAHQJgDSBECaAEgTAGkCIE0ApAmANAGQJgDSBECaAEgTAGkCIE0ApAmANAGQJgDSBECaAEg…",
    "label": "windowpane",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANSUhEUgAAAwAAAAMACAAAAAC26l9SAAAErklEQVR4nO3dMVLDUAxAQcL97xxKKOggkjJv9wJq/GZsf439+IBrnnOjPudGwT0CIE0ApAmANAGQJgDSBECaAEgTAGkC4JzBg2AB0CYA0gRAmgBIEwBpAiBNAFwz+RZUALQJgDQBkCYA0gRAmgC45jE5TACkCYA0AZAmANIEQJoASBMAaQIgTQCkCYA0AZAmANIEQJoASBMAaQIgTQCkCYA0AZAmANIEQJoASBMAaQIgTQCkCYA0AZAmANI…",
    "label": "door",
    "score": null
  },
  {
    "mask": "iVBORw0KGgoAAAANS…
Informazioni su Segformer B5
Segformer B5 è un modello di Community nella categoria Multimodale. Su Railwail, Segformer B5 costa ≈ 0,00030 USD per esecuzione.
Prezzi
| Esecuzione tipica (≈ 1 s su T4) | 0,00030 USD per esecuzione |
|---|---|
| Tempo GPU (T4) | 0,00027 USD per secondo GPU |
- Fatturato in base al tempo GPU effettivamente utilizzato. All'avvio, 3× il prezzo tipico viene riservato dal tuo saldo e regolato successivamente.
- 1 credito = 0,01 USD
Calcolatore di costi
Calcolatore prezzi
Tipico secondo il provider: circa 1 s
Totale
0,03 USD
3 crediti
Per esecuzione
0,0003 USD · 0,03 crediti
Fatturato in base al tempo GPU effettivo; questo è una stima.
API
Nessun esempio API verificato
L'API pubblica passa un formato di input diverso da quello richiesto da questo modello. Usa il playground sopra.
Specifiche
- ID modello
segformer-b5- Sviluppatore
- Community
- Categoria
- Multimodale
- Input
- Testo, Immagine
- Output
- Testo
- Fatturazione
- In base all'utilizzo (token o tempo GPU)
- Voce di catalogo aggiornata
- 23 settembre 2026
Etichette
- replicate
- segmentation
- vision-understanding
- nvidia
- open-weights
Domande frequenti
Cos'è Segformer B5?
Segformer B5 è un modello di Community nella categoria Multimodale.
Quanto costa Segformer B5 su Railwail?
Su Railwail, Segformer B5 costa ≈ 0,00030 USD per esecuzione. Ti viene addebitato ciò che ogni richiesta utilizza effettivamente. L'utilizzo viene pagato con crediti prepagati; 1 credito equivale a 0,01 USD.
Quanto è veloce Segformer B5?
Non ci sono ancora abbastanza esecuzioni misurate di Segformer B5 su Railwail per indicare un tempo di esecuzione. Dipende dall'input, dalle impostazioni e dal carico presso il provider.
Segformer B5 è migliore di BLIP?
Dipende dall'attività. Segformer B5 (Community) e BLIP (Salesforce) sono entrambi modelli nella categoria Multimodale. La pagina di confronto mostra i loro prezzi e le specifiche affiancati.
Confronta Segformer B5 e BLIPSegformer B5 può elaborare immagini?
Sì. Segformer B5 accetta immagini come input oltre al testo.
Modelli comparabili
Tutti in questa categoria- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Tutti i modelli tramite un'API
Una chiave API per tutti i modelli su Railwail. L'utilizzo viene addebitato da crediti prepagati, 1 credito = 0,01 USD.