
BLIP
blip-captioningSalesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- Precio
- ≈ USD 0.00030/ejecución
- Entrada → Salida
- Texto + Imagen → Texto
- Desarrollador
- Salesforce
- Actualizado
- 23 de septiembre de 2026
Playground
Probar BLIP
Entrada y salida
Esta ejecución
aprox. USD 0.0003 · 0.03 créditos
Se reservan USD 0.0009 (0.09 créditos) al inicio; se factura el tiempo real de GPU.
¿Nuevo aquí?
10 créditos gratis (USD 0.10) cuando te registras con Google
Utilizable 24 horas después del registro, hasta 5 ejecuciones por día y como máximo 2 créditos por ejecución. Otros métodos de inicio de sesión comienzan sin créditos. Suficiente para 111 ejecuciones de este modelo.
Examples
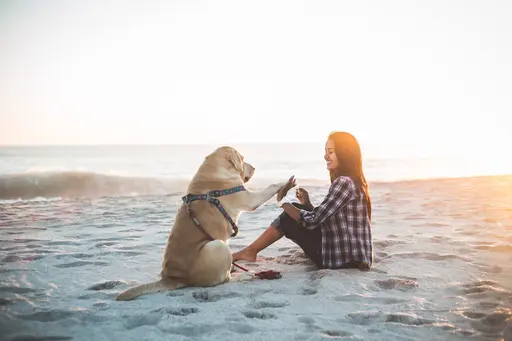 Input
Prompt
image_captioning
Output (JSON, shortened)
[ { "text": "Caption: a woman sitting on the beach with a dog" } ]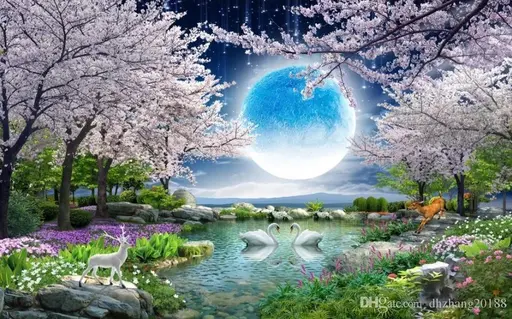 Input
Prompt
what is in the sky?
Output (JSON, shortened)
[ { "text": "Answer: moon" } ] Input
Prompt
what is in the lake?
Output (JSON, shortened)
[
  {
    "text": "Answer: swans"
  }
]
Acerca de BLIP
BLIP es un modelo de Salesforce en la categoría Multimodal. En Railwail, BLIP cuesta ≈ USD 0.00030 por ejecución.
Precios
| Ejecución típica (≈ 1 s en T4) | USD 0.00030 por ejecución |
|---|---|
| Tiempo de GPU (T4) | USD 0.00027 por segundo de GPU |
- Se factura por el tiempo de GPU que realmente toma la ejecución. Cuando comienza la ejecución, se reserva 3× el precio típico de tu saldo y se liquida después.
- 1 crédito = USD 0.01
Calculadora de costos
Calculadora de precios
Típico según el proveedor: aprox. 1 s
Total
USD 0.03
3 créditos
Por ejecución
USD 0.0003 · 0.03 créditos
Se factura el tiempo real de GPU; este es un estimado.
API
Sin ejemplo de API verificado
La API pública pasa un formato de entrada diferente al que necesita este modelo. Usa el playground anterior.
Especificaciones
- ID del modelo
blip-captioning- Desarrollador
- Salesforce
- Categoría
- Multimodal
- Entrada
- Texto, Imagen
- Salida
- Texto
- Facturación
- Por uso (tokens o tiempo de GPU)
- Entrada del catálogo actualizada
- 23 de septiembre de 2026
Parámetros de entrada
Entradas y configuraciones del esquema de entrada del modelo. El ejemplo en la sección API muestra cuáles de ellas acepta la API.
imagerequeridoImage to caption or ask about
Tipo: TextoPredeterminado: –Valores permitidos: –taskTipo: OpciónPredeterminado:image_captioningValores permitidos: image_captioning o visual_question_answeringquestionQuestion for visual question answering mode
Tipo: TextoPredeterminado: –Valores permitidos: –
Etiquetas
- replicate
- blip
- captioning
- vqa
- salesforce
- vision-understanding
- image
Preguntas frecuentes
¿Qué es BLIP?
BLIP es un modelo de Salesforce en la categoría Multimodal.
¿Cuánto cuesta BLIP en Railwail?
En Railwail, BLIP cuesta ≈ USD 0.00030 por ejecución. Se te cobra por lo que cada solicitud realmente usa. El uso se paga con créditos prepagados; 1 crédito equivale a USD 0.01.
¿Qué configuraciones admite BLIP?
Según su esquema de entrada, BLIP conoce estos parámetros: image, task (image_captioning o visual_question_answering) y question.
¿Qué tan rápido es BLIP?
Aún no hay suficientes ejecuciones medidas de BLIP en Railwail para indicar un tiempo de ejecución. Depende de la entrada, la configuración y la carga en el proveedor.
¿Es BLIP mejor que CLIP Interrogator?
Eso depende de la tarea. BLIP (Salesforce) y CLIP Interrogator (Community) son ambos modelos en la categoría Multimodal. La página de comparación muestra sus precios y especificaciones lado a lado.
Comparar BLIP y CLIP Interrogator¿Puede BLIP procesar imágenes?
Sí. BLIP acepta imágenes como entrada además de texto.
Modelos comparables
Todos en esta categoría- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Meta Segment Anything 2. Promptable segmentation across images and video with temporal memory. Zero-shot, point/box/mask prompts, fast on a single H100.
Todos los modelos a través de una API
Una clave API para todos los modelos en Railwail. El uso se cobra con créditos prepagados, 1 crédito = USD 0.01.