
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Cena
- ≈ 0,0114 USD/uruchomienie
- Kontekst
- 8192 tokenów
- Maks. wyjście
- 2048 tokenów
- Wejście → Wyjście
- Tekst + Obraz → Tekst
- Deweloper
- Community
- Zaktualizowano
- 23 września 2026
Playground
Spróbuj CogVLM2 19B
Brak formularza wejściowego
Dla tego modelu nie ma jeszcze formularza wejściowego
Jego wejścia nie są jeszcze udokumentowane. Aby żaden przebieg nie zakończył się niepowodzeniem z powodu błędnego wejścia, nie oferujemy tutaj formularza. Zamiast tego wybierz porównywalny model.
Examples
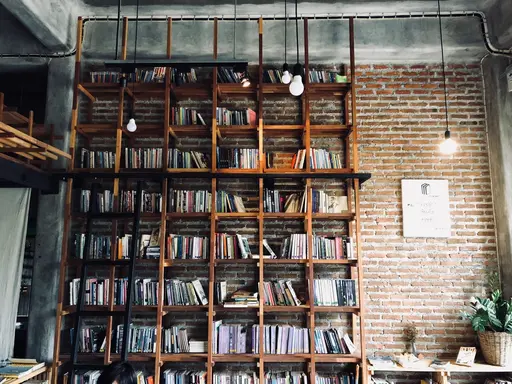 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
O CogVLM2 19B
CogVLM2 19B to model opracowany przez Community w kategorii Multimodalne. W serwisie Railwail CogVLM2 19B kosztuje ≈ 0,0114 USD za uruchomienie. Okno kontekstu zawiera 8192 tokenów, a jedna odpowiedź może mieć do 2048 tokenów.
Ceny
| Typowe uruchomienie (≈ 10 s na L40S) | 0,0114 USD za uruchomienie |
|---|---|
| Czas GPU (L40S) | 0,00117 USD za sekundę GPU |
- Rozliczane są czasy GPU, które przebieg faktycznie zajmuje. Po uruchomieniu przebiegu 3× typowej ceny jest rezerwowane z Twojego salda i rozliczane później.
- 1 kredyt = 0,01 USD
Kalkulator kosztów
Kalkulator cen
Typowo według dostawcy: ok. 9,7 s
Razem
1,14 USD
114 kredytów
Za uruchomienie
0,0114 USD · 1,14 kredytów
Rozliczane są rzeczywiste sekundy GPU; wartość jest szacunkiem.
API
Brak zweryfikowanego przykładu API
Publiczny API przekazuje inny format wejściowy niż wymaga ten model. Użyj placu zabaw powyżej.
Specyfikacje
- ID modelu
cogvlm2-19b- Deweloper
- Community
- Kategoria
- Multimodalne
- Wejście
- Tekst, Obraz
- Wyjście
- Tekst
- Okno kontekstu
- 8192 tokenów
- Maks. wyjście
- 2048 tokenów
- Rozliczenie
- Według użycia (tokeny lub czas GPU)
- Wpis w katalogu zaktualizowany
- 23 września 2026
Tagi
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Często zadawane pytania
Co to jest CogVLM2 19B?
CogVLM2 19B to model opracowany przez Community w kategorii Multimodalne.
Ile kosztuje CogVLM2 19B w serwisie Railwail?
W serwisie Railwail CogVLM2 19B kosztuje ≈ 0,0114 USD za uruchomienie. Opłata jest pobierana za to, co faktycznie zużywa każde żądanie. Użycie jest opłacane z przedpłaconych kredytów; 1 kredyt równa się 0,01 USD.
Jakie jest okno kontekstu CogVLM2 19B?
Okno kontekstu CogVLM2 19B zawiera 8192 tokenów. Jedna odpowiedź może mieć do 2048 tokenów.
Jak szybki jest CogVLM2 19B?
Dla CogVLM2 19B jest jeszcze zbyt mało zmierzonych przebiegów w serwisie Railwail, aby podać czas przebiegu. Zależy to od wejścia, ustawień i obciążenia u dostawcy.
Czy CogVLM2 19B jest lepszy niż BLIP?
To zależy od zadania. CogVLM2 19B (Community) i BLIP (Salesforce) to oba modele z kategorii Multimodalne. Strona porównania pokazuje ich ceny i specyfikacje obok siebie.
Porównaj CogVLM2 19B i BLIPCzy CogVLM2 19B może przetwarzać obrazy?
Tak. CogVLM2 19B akceptuje obrazy jako wejście oprócz tekstu.
Porównywalne modele
Wszystkie w tej kategorii- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Wszystkie modele przez jedno API
Jeden klucz API dla każdego modelu na Railwail. Opłaty pobierane są z przedpłaconych kredytów, 1 kredyt = 0,01 USD.