
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Cena
- ≈ 0,0012 USD/uruchomienie
- Wejście → Wyjście
- Tekst + Obraz → Tekst
- Deweloper
- Community
- Zaktualizowano
- 23 września 2026
Playground
Spróbuj Florence-2 Large
Wejście i wyjście
To uruchomienie
ok. 0,0012 USD · 0,12 kredytów
Na początek rezerwowane jest 0,0036 USD (0,36 kredytów); rozliczana jest rzeczywista czas GPU.
Nowy tutaj?
10 darmowych kredytów (0,10 USD) po zarejestrowaniu się przez Google
Dostępne 24 godzin po rejestracji, do 5 uruchomień dziennie i maksymalnie 2 kredytów na uruchomienie. Inne metody logowania uruchamiają się bez kredytów. Wystarczy na 27 uruchomień tego modelu.
Examples
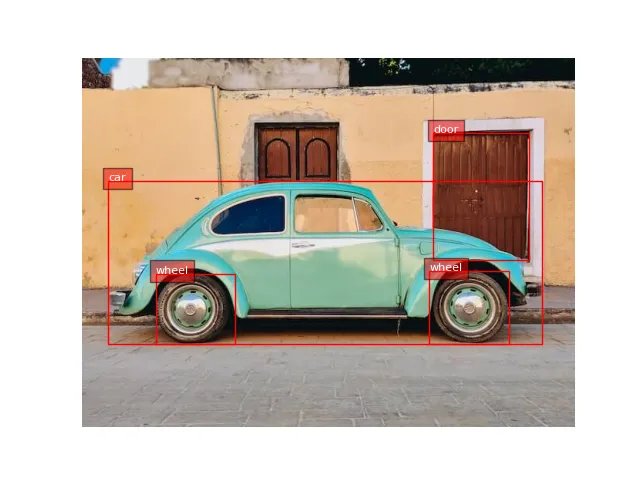 Open full size
 Input
No text prompt: the model only takes the input shown.
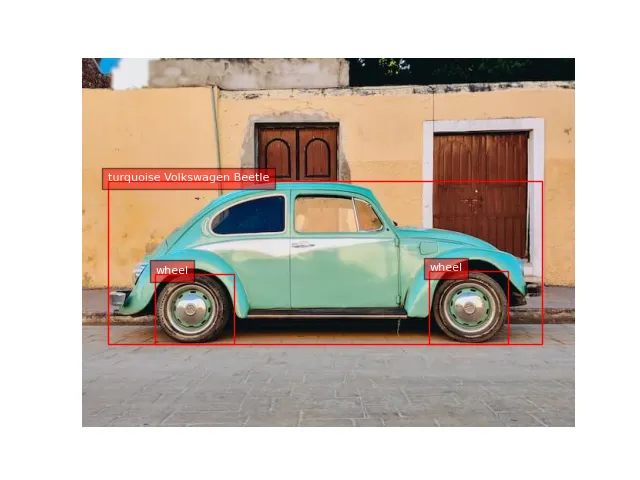 Open full size
 Input
No text prompt: the model only takes the input shown.
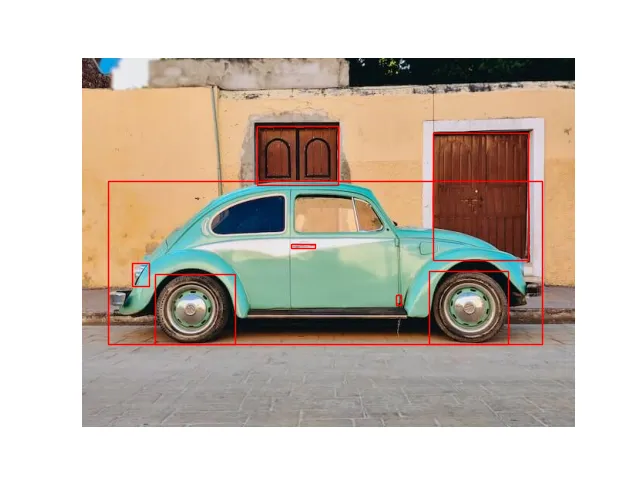 Open full size
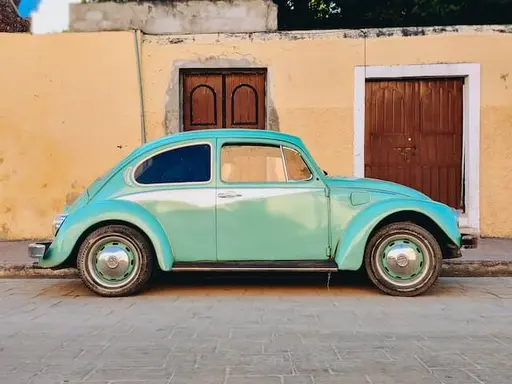 Input
No text prompt: the model only takes the input shown.
O Florence-2 Large
Florence-2 Large to model opracowany przez Community w kategorii Multimodalne. W serwisie Railwail Florence-2 Large kosztuje ≈ 0,0012 USD za uruchomienie.
Ceny
| Typowe uruchomienie (≈ 1 s na L40S) | 0,0012 USD za uruchomienie |
|---|---|
| Czas GPU (L40S) | 0,00117 USD za sekundę GPU |
- Rozliczane są czasy GPU, które przebieg faktycznie zajmuje. Po uruchomieniu przebiegu 3× typowej ceny jest rezerwowane z Twojego salda i rozliczane później.
- 1 kredyt = 0,01 USD
Kalkulator kosztów
Kalkulator cen
Typowo według dostawcy: ok. 1 s
Razem
0,12 USD
12 kredytów
Za uruchomienie
0,0012 USD · 0,12 kredytów
Rozliczane są rzeczywiste sekundy GPU; wartość jest szacunkiem.
API
Brak zweryfikowanego przykładu API
Publiczny API przekazuje inny format wejściowy niż wymaga ten model. Użyj placu zabaw powyżej.
Specyfikacje
- ID modelu
florence-2-large- Deweloper
- Community
- Kategoria
- Multimodalne
- Wejście
- Tekst, Obraz
- Wyjście
- Tekst
- Rozliczenie
- Według użycia (tokeny lub czas GPU)
- Wpis w katalogu zaktualizowany
- 23 września 2026
Parametry wejściowe
Dane wejściowe i ustawienia ze schematu wejściowego modelu. Przykład w sekcji API pokazuje, które z nich API akceptuje.
promptwymaganeUser message or task instruction
Typ: TekstDomyślnie: –Dozwolone wartości: do 4000 znakówtaskTyp: WybórDomyślnie:captionDozwolone wartości: caption, detailed_caption, ocr, object_detection lub segmentationimage_urlImage URL to analyze
Typ: TekstDomyślnie: –Dozwolone wartości: –max_tokensTyp: Liczba całkowitaDomyślnie:1024Dozwolone wartości: 1 do 4096temperatureTyp: LiczbaDomyślnie:0.7Dozwolone wartości: 0 do 2
Tagi
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Często zadawane pytania
Co to jest Florence-2 Large?
Florence-2 Large to model opracowany przez Community w kategorii Multimodalne.
Ile kosztuje Florence-2 Large w serwisie Railwail?
W serwisie Railwail Florence-2 Large kosztuje ≈ 0,0012 USD za uruchomienie. Opłata jest pobierana za to, co faktycznie zużywa każde żądanie. Użycie jest opłacane z przedpłaconych kredytów; 1 kredyt równa się 0,01 USD.
Jakie ustawienia obsługuje Florence-2 Large?
Zgodnie ze schematem wejściowym, Florence-2 Large obsługuje te parametry: prompt (do 4000 znaków), task (caption, detailed_caption, ocr, object_detection lub segmentation), image_url, max_tokens (1 do 4096) i temperature (0 do 2).
Jak szybki jest Florence-2 Large?
Dla Florence-2 Large jest jeszcze zbyt mało zmierzonych przebiegów w serwisie Railwail, aby podać czas przebiegu. Zależy to od wejścia, ustawień i obciążenia u dostawcy.
Czy Florence-2 Large jest lepszy niż BLIP?
To zależy od zadania. Florence-2 Large (Community) i BLIP (Salesforce) to oba modele z kategorii Multimodalne. Strona porównania pokazuje ich ceny i specyfikacje obok siebie.
Porównaj Florence-2 Large i BLIPCzy Florence-2 Large może przetwarzać obrazy?
Tak. Florence-2 Large akceptuje obrazy jako wejście oprócz tekstu.
Porównywalne modele
Wszystkie w tej kategorii- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Wszystkie modele przez jedno API
Jeden klucz API dla każdego modelu na Railwail. Opłaty pobierane są z przedpłaconych kredytów, 1 kredyt = 0,01 USD.