
Florence-2 Segmentation
florence-2-segmentationMicrosoft Florence-2 unified vision model with referring expression segmentation. Text-prompted region and mask generation in one model.
- Cena
- ≈ 0,0012 USD/uruchomienie
- Wejście → Wyjście
- Tekst + Obraz → Tekst
- Deweloper
- Community
- Zaktualizowano
- 23 września 2026
Playground
Spróbuj Florence-2 Segmentation
Brak formularza wejściowego
Dla tego modelu nie ma jeszcze formularza wejściowego
Jego wejścia nie są jeszcze udokumentowane. Aby żaden przebieg nie zakończył się niepowodzeniem z powodu błędnego wejścia, nie oferujemy tutaj formularza. Zamiast tego wybierz porównywalny model.
Examples
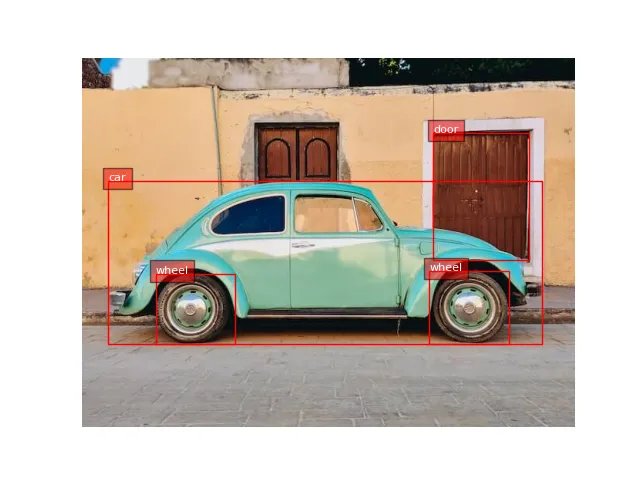 Open full size
 Input
No text prompt: the model only takes the input shown.
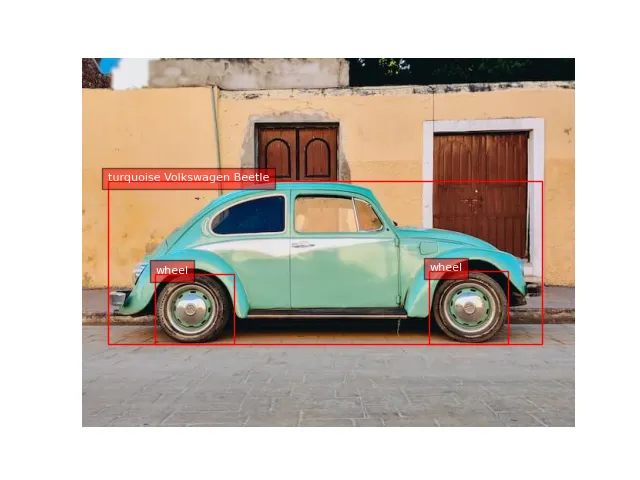 Open full size
 Input
No text prompt: the model only takes the input shown.
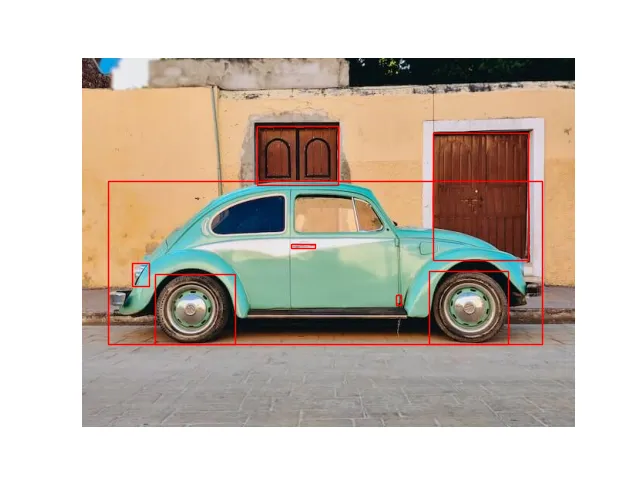 Open full size
 Input
No text prompt: the model only takes the input shown.
O Florence-2 Segmentation
Florence-2 Segmentation to model opracowany przez Community w kategorii Multimodalne. W serwisie Railwail Florence-2 Segmentation kosztuje ≈ 0,0012 USD za uruchomienie.
Ceny
| Typowe uruchomienie (≈ 1 s na L40S) | 0,0012 USD za uruchomienie |
|---|---|
| Czas GPU (L40S) | 0,00117 USD za sekundę GPU |
- Rozliczane są czasy GPU, które przebieg faktycznie zajmuje. Po uruchomieniu przebiegu 3× typowej ceny jest rezerwowane z Twojego salda i rozliczane później.
- 1 kredyt = 0,01 USD
Kalkulator kosztów
Kalkulator cen
Typowo według dostawcy: ok. 1 s
Razem
0,12 USD
12 kredytów
Za uruchomienie
0,0012 USD · 0,12 kredytów
Rozliczane są rzeczywiste sekundy GPU; wartość jest szacunkiem.
API
Brak zweryfikowanego przykładu API
Publiczny API przekazuje inny format wejściowy niż wymaga ten model. Użyj placu zabaw powyżej.
Specyfikacje
- ID modelu
florence-2-segmentation- Deweloper
- Community
- Kategoria
- Multimodalne
- Wejście
- Tekst, Obraz
- Wyjście
- Tekst
- Rozliczenie
- Według użycia (tokeny lub czas GPU)
- Wpis w katalogu zaktualizowany
- 23 września 2026
Tagi
- replicate
- segmentation
- vision-understanding
- microsoft
- open-weights
Często zadawane pytania
Co to jest Florence-2 Segmentation?
Florence-2 Segmentation to model opracowany przez Community w kategorii Multimodalne.
Ile kosztuje Florence-2 Segmentation w serwisie Railwail?
W serwisie Railwail Florence-2 Segmentation kosztuje ≈ 0,0012 USD za uruchomienie. Opłata jest pobierana za to, co faktycznie zużywa każde żądanie. Użycie jest opłacane z przedpłaconych kredytów; 1 kredyt równa się 0,01 USD.
Jak szybki jest Florence-2 Segmentation?
Dla Florence-2 Segmentation jest jeszcze zbyt mało zmierzonych przebiegów w serwisie Railwail, aby podać czas przebiegu. Zależy to od wejścia, ustawień i obciążenia u dostawcy.
Czy Florence-2 Segmentation jest lepszy niż BLIP?
To zależy od zadania. Florence-2 Segmentation (Community) i BLIP (Salesforce) to oba modele z kategorii Multimodalne. Strona porównania pokazuje ich ceny i specyfikacje obok siebie.
Porównaj Florence-2 Segmentation i BLIPCzy Florence-2 Segmentation może przetwarzać obrazy?
Tak. Florence-2 Segmentation akceptuje obrazy jako wejście oprócz tekstu.
Porównywalne modele
Wszystkie w tej kategorii- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ 0,0457 USD/uruchomienie
3708 % drożej za jednostkę
Porównaj Florence-2 Segmentation i CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ 0,0050 USD/uruchomienie
317 % drożej za jednostkę
Porównaj Florence-2 Segmentation i Depth Anything v2
Wszystkie modele przez jedno API
Jeden klucz API dla każdego modelu na Railwail. Opłaty pobierane są z przedpłaconych kredytów, 1 kredyt = 0,01 USD.