
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Цена
- ≈ 0,0086 $/запуск
- Контекст
- 4 096 токенов
- Макс. выход
- 2 048 токенов
- Вход → выход
- Текст + Изображение → Текст
- Разработчик
- DeepSeek
- Обновлено
- 23 сентября 2026 г.
Playground
Попробовать DeepSeek-VL 7B
Нет формы ввода
Для этой модели ещё нет формы ввода
Её входные данные ещё не задокументированы. Чтобы запуск не сбился на неправильном входе, мы не предлагаем форму. Выберите сравнимую модель.
Examples
 Input
Prompt
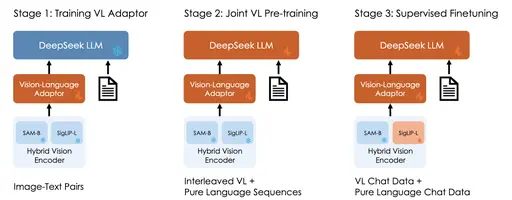
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
 Input
Prompt
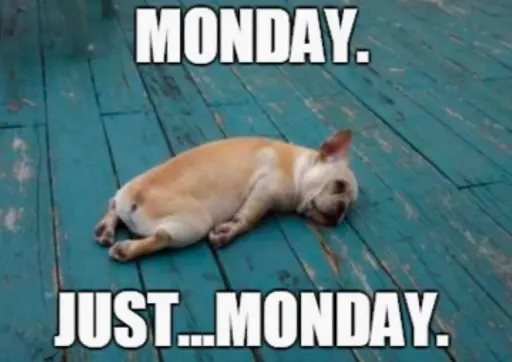
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
О DeepSeek-VL 7B
DeepSeek-VL 7B — это модель от DeepSeek в категории Мультимодальные. На Railwail DeepSeek-VL 7B стоит ≈ 0,0086 $ за запуск. Контекстное окно содержит 4 096 токенов, ответ может быть до 2 048 токенов.
Цены
| Типичный запуск (≈ 7 с на L40S) | 0,0086 $ за запуск |
|---|---|
| Время GPU (L40S) | 0,00117 $ за секунду GPU |
- Оплата рассчитывается по времени GPU, которое фактически требуется для запуска. При запуске из вашего баланса резервируется 3× типичная цена, которая затем списывается.
- 1 кредит = 0,01 $
Калькулятор стоимости
Калькулятор цен
По данным поставщика: примерно 7,3 с
Итого
0,86 $
86 кредитов
За запуск
0,0086 $ · 0,86 кредитов
Выставляется счет за фактическое время GPU; это оценка.
API
Нет проверенного примера API
Публичный API передает другой формат входных данных, чем требует эта модель. Используйте playground выше.
Спецификации
- ID модели
deepseek-vl-7b- Разработчик
- DeepSeek
- Категория
- Мультимодальные
- Входные данные
- Текст, Изображение
- Выходные данные
- Текст
- Контекстное окно
- 4 096 токенов
- Макс. выходные данные
- 2 048 токенов
- Тарификация
- По использованию (токены или время GPU)
- Запись в каталоге обновлена
- 23 сентября 2026 г.
Теги
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Часто задаваемые вопросы
Что такое DeepSeek-VL 7B?
DeepSeek-VL 7B — модель от DeepSeek в категории Мультимодальные.
Сколько стоит DeepSeek-VL 7B на Railwail?
На Railwail DeepSeek-VL 7B стоит ≈ 0,0086 $ за запуск. Вы платите за то, что фактически использует каждый запрос. Использование оплачивается предоплаченными кредитами; 1 кредит = 0,01 $.
Какой размер контекстного окна у DeepSeek-VL 7B?
Контекстное окно DeepSeek-VL 7B содержит 4 096 токенов. Ответ может быть до 2 048 токенов.
Насколько быстра DeepSeek-VL 7B?
На Railwail пока недостаточно измеренных запусков DeepSeek-VL 7B, чтобы указать время выполнения. Оно зависит от входных данных, параметров и нагрузки на провайдера.
DeepSeek-VL 7B лучше, чем BLIP?
Это зависит от задачи. DeepSeek-VL 7B (DeepSeek) и BLIP (Salesforce) — обе модели в категории Мультимодальные. На странице сравнения показаны их цены и характеристики рядом.
Сравнить DeepSeek-VL 7B и BLIPМожет ли DeepSeek-VL 7B обрабатывать изображения?
Да. DeepSeek-VL 7B принимает изображения на входе в дополнение к тексту.
Сравнимые модели
Все в этой категории- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Все модели через один API
Один API-ключ для всех моделей на Railwail. Использование оплачивается из предоплаченных кредитов, 1 кредит = 0,01 $.