
Florence-2 Large
florence-2-largeMicrosoft Florence-2 Large. Unified prompt-based vision foundation model for captioning, detection, segmentation and OCR with a single 770M-param backbone.
- Цена
- ≈ 0,0012 $/запуск
- Вход → выход
- Текст + Изображение → Текст
- Разработчик
- Community
- Обновлено
- 23 сентября 2026 г.
Playground
Попробовать Florence-2 Large
Входные данные и результат
Этот запуск
примерно 0,0012 $ · 0,12 кредитов
При запуске зарезервировано 0,0036 $ (0,36 кредитов); оплачивается фактическое время GPU.
Впервые здесь?
10 бесплатных кредитов (0,10 $) при регистрации через Google
Доступно 24 часов после регистрации, до 5 запусков в день и максимум 2 кредитов за запуск. Другие способы входа начинают без кредитов. Достаточно для 27 запусков этой модели.
Examples
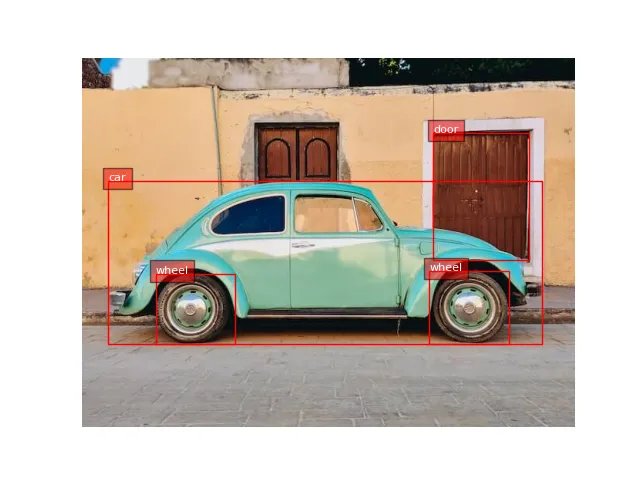 Open full size
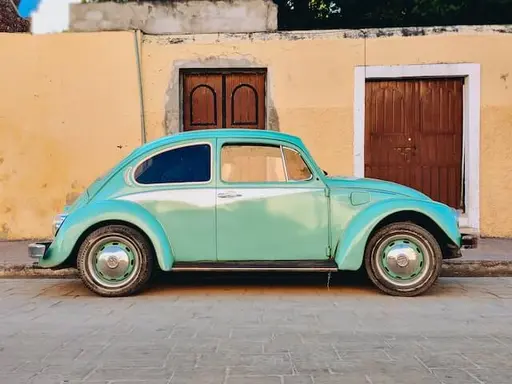 Input
No text prompt: the model only takes the input shown.
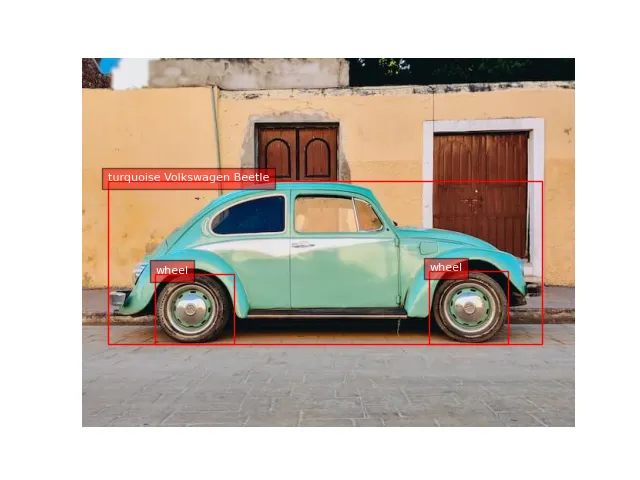 Open full size
 Input
No text prompt: the model only takes the input shown.
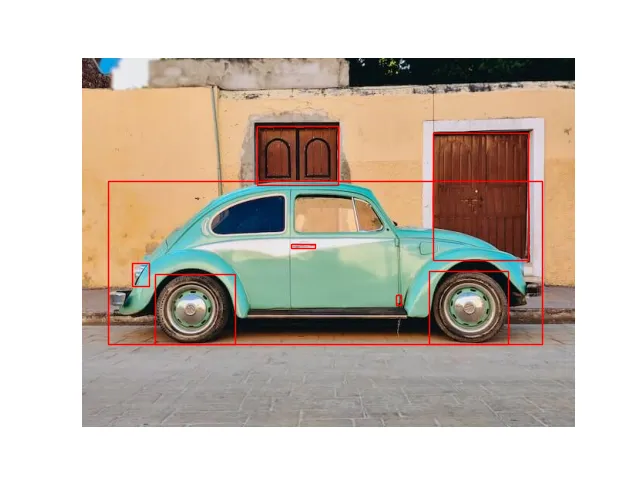 Open full size
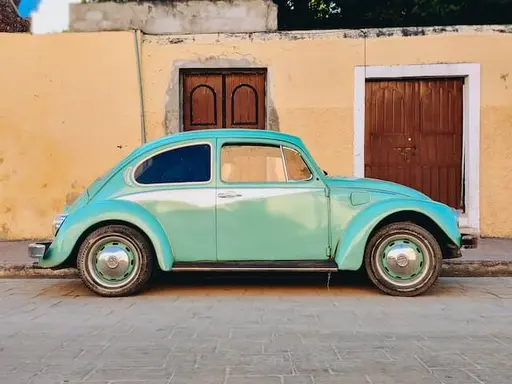 Input
No text prompt: the model only takes the input shown.
О Florence-2 Large
Florence-2 Large — это модель от Community в категории Мультимодальные. На Railwail Florence-2 Large стоит ≈ 0,0012 $ за запуск.
Цены
| Типичный запуск (≈ 1 с на L40S) | 0,0012 $ за запуск |
|---|---|
| Время GPU (L40S) | 0,00117 $ за секунду GPU |
- Оплата рассчитывается по времени GPU, которое фактически требуется для запуска. При запуске из вашего баланса резервируется 3× типичная цена, которая затем списывается.
- 1 кредит = 0,01 $
Калькулятор стоимости
Калькулятор цен
По данным поставщика: примерно 1 с
Итого
0,12 $
12 кредитов
За запуск
0,0012 $ · 0,12 кредитов
Выставляется счет за фактическое время GPU; это оценка.
API
Нет проверенного примера API
Публичный API передает другой формат входных данных, чем требует эта модель. Используйте playground выше.
Спецификации
- ID модели
florence-2-large- Разработчик
- Community
- Категория
- Мультимодальные
- Входные данные
- Текст, Изображение
- Выходные данные
- Текст
- Тарификация
- По использованию (токены или время GPU)
- Запись в каталоге обновлена
- 23 сентября 2026 г.
Входные параметры
Входные данные и параметры из схемы входных данных модели. Пример в разделе API показывает, какие из них принимает API.
promptобязательноUser message or task instruction
Тип: ТекстПо умолчанию: –Допустимые значения: до 4 000 символовtaskТип: ВыборПо умолчанию:captionДопустимые значения: caption, detailed_caption, ocr, object_detection или segmentationimage_urlImage URL to analyze
Тип: ТекстПо умолчанию: –Допустимые значения: –max_tokensТип: Целое числоПо умолчанию:1024Допустимые значения: от 1 до 4 096temperatureТип: ЧислоПо умолчанию:0.7Допустимые значения: от 0 до 2
Теги
- replicate
- multimodal
- vision-understanding
- microsoft
- open-weights
Часто задаваемые вопросы
Что такое Florence-2 Large?
Florence-2 Large — модель от Community в категории Мультимодальные.
Сколько стоит Florence-2 Large на Railwail?
На Railwail Florence-2 Large стоит ≈ 0,0012 $ за запуск. Вы платите за то, что фактически использует каждый запрос. Использование оплачивается предоплаченными кредитами; 1 кредит = 0,01 $.
Какие параметры поддерживает Florence-2 Large?
Согласно схеме входных данных, Florence-2 Large поддерживает эти параметры: prompt (до 4 000 символов), task (caption, detailed_caption, ocr, object_detection или segmentation), image_url, max_tokens (от 1 до 4 096) и temperature (от 0 до 2).
Насколько быстра Florence-2 Large?
На Railwail пока недостаточно измеренных запусков Florence-2 Large, чтобы указать время выполнения. Оно зависит от входных данных, параметров и нагрузки на провайдера.
Florence-2 Large лучше, чем BLIP?
Это зависит от задачи. Florence-2 Large (Community) и BLIP (Salesforce) — обе модели в категории Мультимодальные. На странице сравнения показаны их цены и характеристики рядом.
Сравнить Florence-2 Large и BLIPМожет ли Florence-2 Large обрабатывать изображения?
Да. Florence-2 Large принимает изображения на входе в дополнение к тексту.
Сравнимые модели
Все в этой категории- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Все модели через один API
Один API-ключ для всех моделей на Railwail. Использование оплачивается из предоплаченных кредитов, 1 кредит = 0,01 $.