
CogVLM2 19B
cogvlm2-19bTsinghua CogVLM2 19B with Llama-3 8B base plus 11B vision expert. Strong document understanding and visual reasoning, 8k context.
- Precio
- ≈ USD 0.0114/ejecución
- Contexto
- 8,192 tokens
- Salida máxima
- 2,048 tokens
- Entrada → Salida
- Texto + Imagen → Texto
- Desarrollador
- Community
- Actualizado
- 23 de septiembre de 2026
Playground
Probar CogVLM2 19B
Sin formulario de entrada
Aún no hay formulario de entrada para este modelo
Sus entradas aún no están documentadas. Para evitar errores por entradas incorrectas, no ofrecemos un formulario aquí. Elige un modelo comparable en su lugar.
Examples
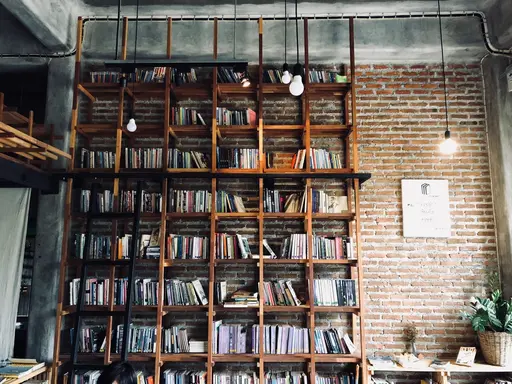 Input
Prompt
Describe this image.
Response
The image captures a well-lit, modern library or bookstore with a distinct industrial aesthetic. The main focus is a large, wooden bookshelf filled with an assortment of books, creating a warm and inviting atmosphere. The bookshelf is positioned against a rustic brick wall, which adds a touch of vintage charm to the space. The room is illuminated by hanging light bulbs, which dangle from the ceiling in a casual manner. There are also decorative elements such as a potted plant, a small framed sign, and a table with various items on it, enhancing the cozy ambiance. A person is seated at a desk in the foreground, suggesting the space is functional for reading or studying.
Acerca de CogVLM2 19B
CogVLM2 19B es un modelo de Community en la categoría Multimodal. En Railwail, CogVLM2 19B cuesta ≈ USD 0.0114 por ejecución. La ventana de contexto contiene 8,192 tokens, y una respuesta puede tener hasta 2,048 tokens.
Precios
| Ejecución típica (≈ 10 s en L40S) | USD 0.0114 por ejecución |
|---|---|
| Tiempo de GPU (L40S) | USD 0.00117 por segundo de GPU |
- Se factura por el tiempo de GPU que realmente toma la ejecución. Cuando comienza la ejecución, se reserva 3× el precio típico de tu saldo y se liquida después.
- 1 crédito = USD 0.01
Calculadora de costos
Calculadora de precios
Típico según el proveedor: aprox. 9.7 s
Total
USD 1.14
114 créditos
Por ejecución
USD 0.0114 · 1.14 créditos
Se factura el tiempo real de GPU; este es un estimado.
API
Sin ejemplo de API verificado
La API pública pasa un formato de entrada diferente al que necesita este modelo. Usa el playground anterior.
Especificaciones
- ID del modelo
cogvlm2-19b- Desarrollador
- Community
- Categoría
- Multimodal
- Entrada
- Texto, Imagen
- Salida
- Texto
- Ventana de contexto
- 8,192 tokens
- Salida máxima
- 2,048 tokens
- Facturación
- Por uso (tokens o tiempo de GPU)
- Entrada del catálogo actualizada
- 23 de septiembre de 2026
Etiquetas
- replicate
- multimodal
- vision-understanding
- tsinghua
- open-weights
Preguntas frecuentes
¿Qué es CogVLM2 19B?
CogVLM2 19B es un modelo de Community en la categoría Multimodal.
¿Cuánto cuesta CogVLM2 19B en Railwail?
En Railwail, CogVLM2 19B cuesta ≈ USD 0.0114 por ejecución. Se te cobra por lo que cada solicitud realmente usa. El uso se paga con créditos prepagados; 1 crédito equivale a USD 0.01.
¿Cuál es la ventana de contexto de CogVLM2 19B?
La ventana de contexto de CogVLM2 19B contiene 8,192 tokens. Una respuesta puede tener hasta 2,048 tokens.
¿Qué tan rápido es CogVLM2 19B?
Aún no hay suficientes ejecuciones medidas de CogVLM2 19B en Railwail para indicar un tiempo de ejecución. Depende de la entrada, la configuración y la carga en el proveedor.
¿Es CogVLM2 19B mejor que BLIP?
Eso depende de la tarea. CogVLM2 19B (Community) y BLIP (Salesforce) son ambos modelos en la categoría Multimodal. La página de comparación muestra sus precios y especificaciones lado a lado.
Comparar CogVLM2 19B y BLIP¿Puede CogVLM2 19B procesar imágenes?
Sí. CogVLM2 19B acepta imágenes como entrada además de texto.
Modelos comparables
Todos en esta categoría- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Todos los modelos a través de una API
Una clave API para todos los modelos en Railwail. El uso se cobra con créditos prepagados, 1 crédito = USD 0.01.