
DeepSeek-VL 7B
deepseek-vl-7bDeepSeek-VL 7B chat model. Vision-language model with hybrid vision encoder and strong real-world visual question answering performance.
- Precio
- ≈ USD 0.0086/ejecución
- Contexto
- 4,096 tokens
- Salida máxima
- 2,048 tokens
- Entrada → Salida
- Texto + Imagen → Texto
- Desarrollador
- DeepSeek
- Actualizado
- 23 de septiembre de 2026
Playground
Probar DeepSeek-VL 7B
Sin formulario de entrada
Aún no hay formulario de entrada para este modelo
Sus entradas aún no están documentadas. Para evitar errores por entradas incorrectas, no ofrecemos un formulario aquí. Elige un modelo comparable en su lugar.
Examples
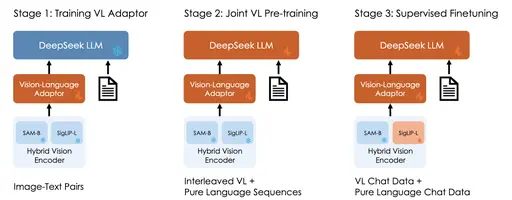 Input
Prompt
Describe each stage of this image
Response
The image depicts a three-stage process for training a vision-language model. 1. Stage 1: Training VL Adapter: In this stage, a vision-language adapter is trained using supervised fine-tuning. The adapter is trained on image-text pairs and pure language sequences. 2. Stage 2: Joint VL Pre-training: In this stage, a joint vision-language model is pre-trained using self-supervised learning. The model is trained on image-text pairs and pure language sequences. 3. Stage 3: Supervised Fine-tuning: In this stage, the model is fine-tuned on supervised tasks using image-text pairs and pure language sequences. The model is trained using a hybrid vision-language adapter, which combines a vision-language adapter with a language model. The model is trained on a variety of tasks, including image captioning, visual question answering, and visual reasoning. The model is able to understand the visual content of an image and generate a natural language description or answer.
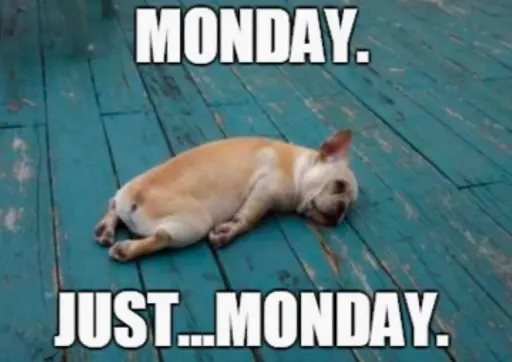 Input
Prompt
Describe this image
Response
The image you've provided is a meme featuring a French Bulldog lying on its side on a blue wooden floor. The dog's head is resting on its paws, and it appears to be sleeping. The meme has a text overlay that reads "MONDAY. JUST...MONDAY." This suggests that the meme is making a humorous comment about the start of the work week. The dog's relaxed posture and the text overlay together create a light-hearted and relatable message.
Acerca de DeepSeek-VL 7B
DeepSeek-VL 7B es un modelo de DeepSeek en la categoría Multimodal. En Railwail, DeepSeek-VL 7B cuesta ≈ USD 0.0086 por ejecución. La ventana de contexto contiene 4,096 tokens, y una respuesta puede tener hasta 2,048 tokens.
Precios
| Ejecución típica (≈ 7 s en L40S) | USD 0.0086 por ejecución |
|---|---|
| Tiempo de GPU (L40S) | USD 0.00117 por segundo de GPU |
- Se factura por el tiempo de GPU que realmente toma la ejecución. Cuando comienza la ejecución, se reserva 3× el precio típico de tu saldo y se liquida después.
- 1 crédito = USD 0.01
Calculadora de costos
Calculadora de precios
Típico según el proveedor: aprox. 7.3 s
Total
USD 0.86
86 créditos
Por ejecución
USD 0.0086 · 0.86 créditos
Se factura el tiempo real de GPU; este es un estimado.
API
Sin ejemplo de API verificado
La API pública pasa un formato de entrada diferente al que necesita este modelo. Usa el playground anterior.
Especificaciones
- ID del modelo
deepseek-vl-7b- Desarrollador
- DeepSeek
- Categoría
- Multimodal
- Entrada
- Texto, Imagen
- Salida
- Texto
- Ventana de contexto
- 4,096 tokens
- Salida máxima
- 2,048 tokens
- Facturación
- Por uso (tokens o tiempo de GPU)
- Entrada del catálogo actualizada
- 23 de septiembre de 2026
Etiquetas
- replicate
- multimodal
- vision-understanding
- deepseek
- open-weights
Preguntas frecuentes
¿Qué es DeepSeek-VL 7B?
DeepSeek-VL 7B es un modelo de DeepSeek en la categoría Multimodal.
¿Cuánto cuesta DeepSeek-VL 7B en Railwail?
En Railwail, DeepSeek-VL 7B cuesta ≈ USD 0.0086 por ejecución. Se te cobra por lo que cada solicitud realmente usa. El uso se paga con créditos prepagados; 1 crédito equivale a USD 0.01.
¿Cuál es la ventana de contexto de DeepSeek-VL 7B?
La ventana de contexto de DeepSeek-VL 7B contiene 4,096 tokens. Una respuesta puede tener hasta 2,048 tokens.
¿Qué tan rápido es DeepSeek-VL 7B?
Aún no hay suficientes ejecuciones medidas de DeepSeek-VL 7B en Railwail para indicar un tiempo de ejecución. Depende de la entrada, la configuración y la carga en el proveedor.
¿Es DeepSeek-VL 7B mejor que BLIP?
Eso depende de la tarea. DeepSeek-VL 7B (DeepSeek) y BLIP (Salesforce) son ambos modelos en la categoría Multimodal. La página de comparación muestra sus precios y especificaciones lado a lado.
Comparar DeepSeek-VL 7B y BLIP¿Puede DeepSeek-VL 7B procesar imágenes?
Sí. DeepSeek-VL 7B acepta imágenes como entrada además de texto.
Modelos comparables
Todos en esta categoría- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
- Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
Todos los modelos a través de una API
Una clave API para todos los modelos en Railwail. El uso se cobra con créditos prepagados, 1 crédito = USD 0.01.