
Llama 3.2 Vision 11B (Ollama)
llama-3-2-vision-11b-ollamaMeta Llama 3.2 11B Vision served via Ollama on Replicate. Open-weights multimodal model for image captioning, document and chart reading, and visual question answering.
- Precio
- ≈ USD 0.0039/ejecución
- Entrada → Salida
- Texto + Imagen → Texto
- Desarrollador
- Community
- Actualizado
- 23 de septiembre de 2026
Playground
Probar Llama 3.2 Vision 11B (Ollama)
Entrada y salida
Esta ejecución
aprox. USD 0.0039 · 0.39 créditos
Se reservan USD 0.0116 (1.16 créditos) al inicio; se factura el tiempo real de GPU.
¿Nuevo aquí?
10 créditos gratis (USD 0.10) cuando te registras con Google
Utilizable 24 horas después del registro, hasta 5 ejecuciones por día y como máximo 2 créditos por ejecución. Otros métodos de inicio de sesión comienzan sin créditos. Suficiente para 8 ejecuciones de este modelo.
Examples
 Input
Prompt
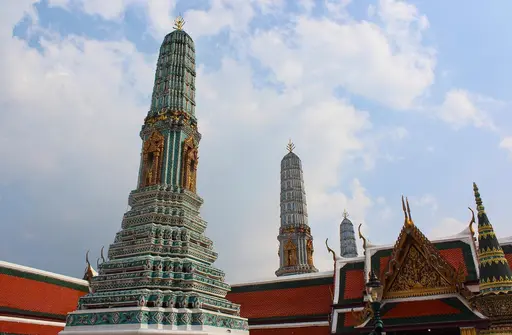
Where to find this monument? Can you give me other recommendations around the area?
Response
**Wat Phra Kaew (Temple of the Emerald Buddha)** in Bangkok, Thailand. Located within the Grand Palace complex, Wat Phra Kaew is a highly revered and sacred site that houses the iconic Emerald Buddha image. The temple's design incorporates traditional Thai architecture with intricate details and ornate decorations, featuring an imposing spire topped by a golden finial adorned with images of mythical creatures. **Recommendations for Your Visit:** * **Grand Palace**: Explore the sprawling palace grounds, which include several other notable temples and buildings. * **Wat Arun (Temple of Dawn)**: A nearby temple famous for its distinctive spire covered in colorful ceramics and glints of gold. * **Chao Phraya River Cruise**: Take a boat ride along the river to admire the city's skyline and learn about its history. * **Jim Thompson House Museum**: Visit this museum dedicated to Thai art and culture, featuring traditional architecture and beautiful gardens. Wat Phra Kaew is an absolute must-visit attraction when in Bangkok. With these recommendations, you'll have a well-rounded experience of the city's rich cultural heritage.
 Input
Prompt
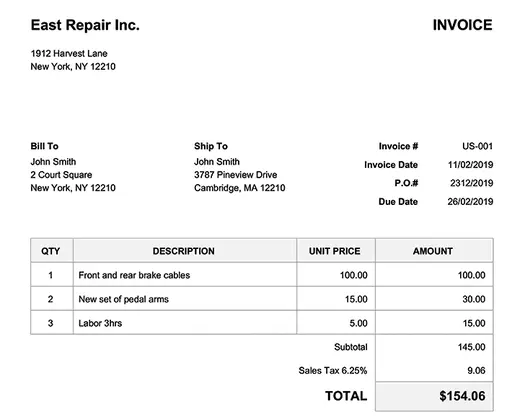
How long does it take from invoice date to due date? Be short and concise.
Response
From the invoice date of 11/02/2019 to the due date of 26/02/2019, there is a difference of **15 days**. This calculation was performed by subtracting the invoice date from the due date: 26/02/2019 - 11/02/2019 = 15
 Input
Prompt
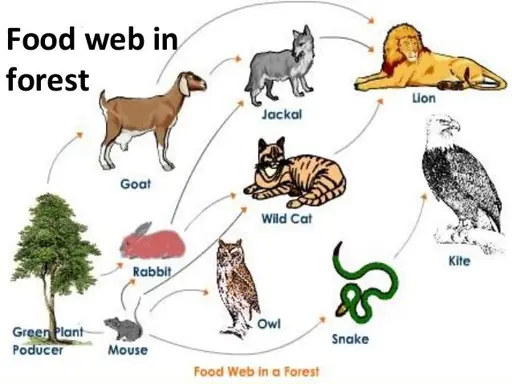
What happens when you take out white cat from this chain?
Response
The white cat is not present in the food web. The correct term for a wild animal would be "wildcat." If we were to remove a wildcat from the ecosystem, it would no longer be able to hunt or prey on other animals. This could have cascading effects throughout the entire ecosystem. *Answer*: Wildcat will lose its source of food and nutrients
Acerca de Llama 3.2 Vision 11B (Ollama)
Llama 3.2 Vision 11B (Ollama) es un modelo de Community en la categoría Multimodal. En Railwail, Llama 3.2 Vision 11B (Ollama) cuesta ≈ USD 0.0039 por ejecución.
Precios
| Ejecución típica (≈ 3 s en L40S) | USD 0.0039 por ejecución |
|---|---|
| Tiempo de GPU (L40S) | USD 0.00117 por segundo de GPU |
- Se factura por el tiempo de GPU que realmente toma la ejecución. Cuando comienza la ejecución, se reserva 3× el precio típico de tu saldo y se liquida después.
- 1 crédito = USD 0.01
Calculadora de costos
Calculadora de precios
Típico según el proveedor: aprox. 3.3 s
Total
USD 0.39
39 créditos
Por ejecución
USD 0.0039 · 0.39 créditos
Se factura el tiempo real de GPU; este es un estimado.
API
Sin ejemplo de API verificado
La API pública pasa un formato de entrada diferente al que necesita este modelo. Usa el playground anterior.
Especificaciones
- ID del modelo
llama-3-2-vision-11b-ollama- Desarrollador
- Community
- Categoría
- Multimodal
- Entrada
- Texto, Imagen
- Salida
- Texto
- Facturación
- Por uso (tokens o tiempo de GPU)
- Entrada del catálogo actualizada
- 23 de septiembre de 2026
Parámetros de entrada
Entradas y configuraciones del esquema de entrada del modelo. El ejemplo en la sección API muestra cuáles de ellas acepta la API.
promptrequeridoQuestion about the image
Tipo: TextoPredeterminado: –Valores permitidos: hasta 16,000 caracteresimage_urlImage URL to analyze
Tipo: TextoPredeterminado: –Valores permitidos: –max_tokensTipo: Número enteroPredeterminado:1024Valores permitidos: 1 a 4,096temperatureTipo: NúmeroPredeterminado:0.7Valores permitidos: 0 a 2
Etiquetas
- replicate
- meta
- llama
- vision-understanding
- open-weights
- ollama
Preguntas frecuentes
¿Qué es Llama 3.2 Vision 11B (Ollama)?
Llama 3.2 Vision 11B (Ollama) es un modelo de Community en la categoría Multimodal.
¿Cuánto cuesta Llama 3.2 Vision 11B (Ollama) en Railwail?
En Railwail, Llama 3.2 Vision 11B (Ollama) cuesta ≈ USD 0.0039 por ejecución. Se te cobra por lo que cada solicitud realmente usa. El uso se paga con créditos prepagados; 1 crédito equivale a USD 0.01.
¿Qué configuraciones admite Llama 3.2 Vision 11B (Ollama)?
Según su esquema de entrada, Llama 3.2 Vision 11B (Ollama) conoce estos parámetros: prompt (hasta 16,000 caracteres), image_url, max_tokens (1 a 4,096) y temperature (0 a 2).
¿Qué tan rápido es Llama 3.2 Vision 11B (Ollama)?
Aún no hay suficientes ejecuciones medidas de Llama 3.2 Vision 11B (Ollama) en Railwail para indicar un tiempo de ejecución. Depende de la entrada, la configuración y la carga en el proveedor.
¿Es Llama 3.2 Vision 11B (Ollama) mejor que BLIP?
Eso depende de la tarea. Llama 3.2 Vision 11B (Ollama) (Community) y BLIP (Salesforce) son ambos modelos en la categoría Multimodal. La página de comparación muestra sus precios y especificaciones lado a lado.
Comparar Llama 3.2 Vision 11B (Ollama) y BLIP¿Puede Llama 3.2 Vision 11B (Ollama) procesar imágenes?
Sí. Llama 3.2 Vision 11B (Ollama) acepta imágenes como entrada además de texto.
Modelos comparables
Todos en esta categoría- BLIPSalesforce
Salesforce BLIP. Vision-language model for image captioning and visual question answering. Given an image it writes a short natural-language caption, or answers a question about the image when one is supplied. A widely used baseline for automatic captioning.
- CLIP InterrogatorCommunity
pharmapsychotic's CLIP Interrogator. Takes an image and produces a Stable-Diffusion-style text prompt by combining BLIP captioning with CLIP to rank likely subjects, artists, mediums and styles. Commonly used to reverse-engineer a prompt from an existing picture.
≈ USD 0.0457/ejecución
1,072 % más caro por unidad
Comparar Llama 3.2 Vision 11B (Ollama) vs. CLIP Interrogator - Depth Anything v2Community
Monocular depth-estimation model trained on 595k labeled and 62M unlabeled images. Strong zero-shot generalization in indoor and outdoor scenes.
≈ USD 0.0050/ejecución
28 % más caro por unidad
Comparar Llama 3.2 Vision 11B (Ollama) vs. Depth Anything v2
Todos los modelos a través de una API
Una clave API para todos los modelos en Railwail. El uso se cobra con créditos prepagados, 1 crédito = USD 0.01.